O Ollama passou a gerar áudio a partir de texto. O primeiro modelo de voz da plataforma é o Phonon, da francesa Gradium: compacto, roda localmente e tem versões em português, inglês, espanhol, francês e alemão.
O Ollama agora dá suporte a text-to-speech
O Ollama anunciou no dia 24 de outubro o suporte a modelos de text-to-speech (TTS), aqueles que transformam texto em fala. O primeiro modelo disponível é o Phonon, uma família de modelos de voz compactos criada pela Gradium, startup francesa especializada em IA de voz.
A novidade chama atenção pelo peso do Ollama no ecossistema. Com mais de 180 mil estrelas no GitHub, o projeto se tornou um dos maiores repositórios de modelos abertos e uma das principais portas de entrada para quem quer rodar IA localmente, no próprio computador, sem depender de uma API externa. Gemma, Qwen, Llama e DeepSeek estão a um comando de distância.
Até agora, porém, o Ollama era sinônimo de modelos que leem e escrevem texto. Com o suporte a voz, a plataforma passa a cobrir também a etapa da fala: um modelo de linguagem escreve a resposta e o Phonon a transforma em áudio, tudo na mesma máquina e sem que nenhum dado saia do computador.
Quem é a Gradium
A Gradium é uma startup de Paris fundada em setembro de 2025 como um spin-off do Kyutai, laboratório francês de pesquisa em IA sem fins lucrativos, financiado pelo bilionário Xavier Niel e conhecido pelo Moshi, um dos primeiros modelos abertos de conversa por voz em tempo real. À frente da empresa está Neil Zeghidour, membro fundador do Kyutai e ex-pesquisador de modelos de voz no Google DeepMind.
A proposta da Gradium é construir modelos de voz com latência muito baixa, para que assistentes e agentes respondam quase instantaneamente. O portfólio inclui modelos de texto para fala e de fala para texto em tempo real, o tradutor de voz Gradium Translate, o Gradbot, um framework open source para criar agentes de voz, e agora o Phonon, pensado para rodar direto no dispositivo.
Phonon: voz de qualidade em menos de 50 milhões de parâmetros
A Gradium abriu os pesos do Phonon no dia 20 de outubro. São modelos minúsculos para os padrões atuais: o menor tem 31 milhões de parâmetros e os demais, 40 milhões, enquanto modelos de linguagem locais costumam ter bilhões. No Ollama, os downloads ficam entre 104 MB e 148 MB, e o modelo ocupa de 120 MB a 140 MB de memória quando carregado.
Mesmo pequeno, o Phonon promete qualidade de modelos maiores. Em testes cegos de preferência, com mais de 1.100 avaliadores e 17 mil votos, a Gradium afirma que ele ficou à frente das alternativas abertas comparadas, como Kokoro, Magpie, NeuTTS e Pocket TTS, em todos os idiomas avaliados. Na taxa de erro de palavras (WER), medida em 500 frases difíceis, o Phonon 31m ficou em 1,70%, contra 3,50% do Kokoro.
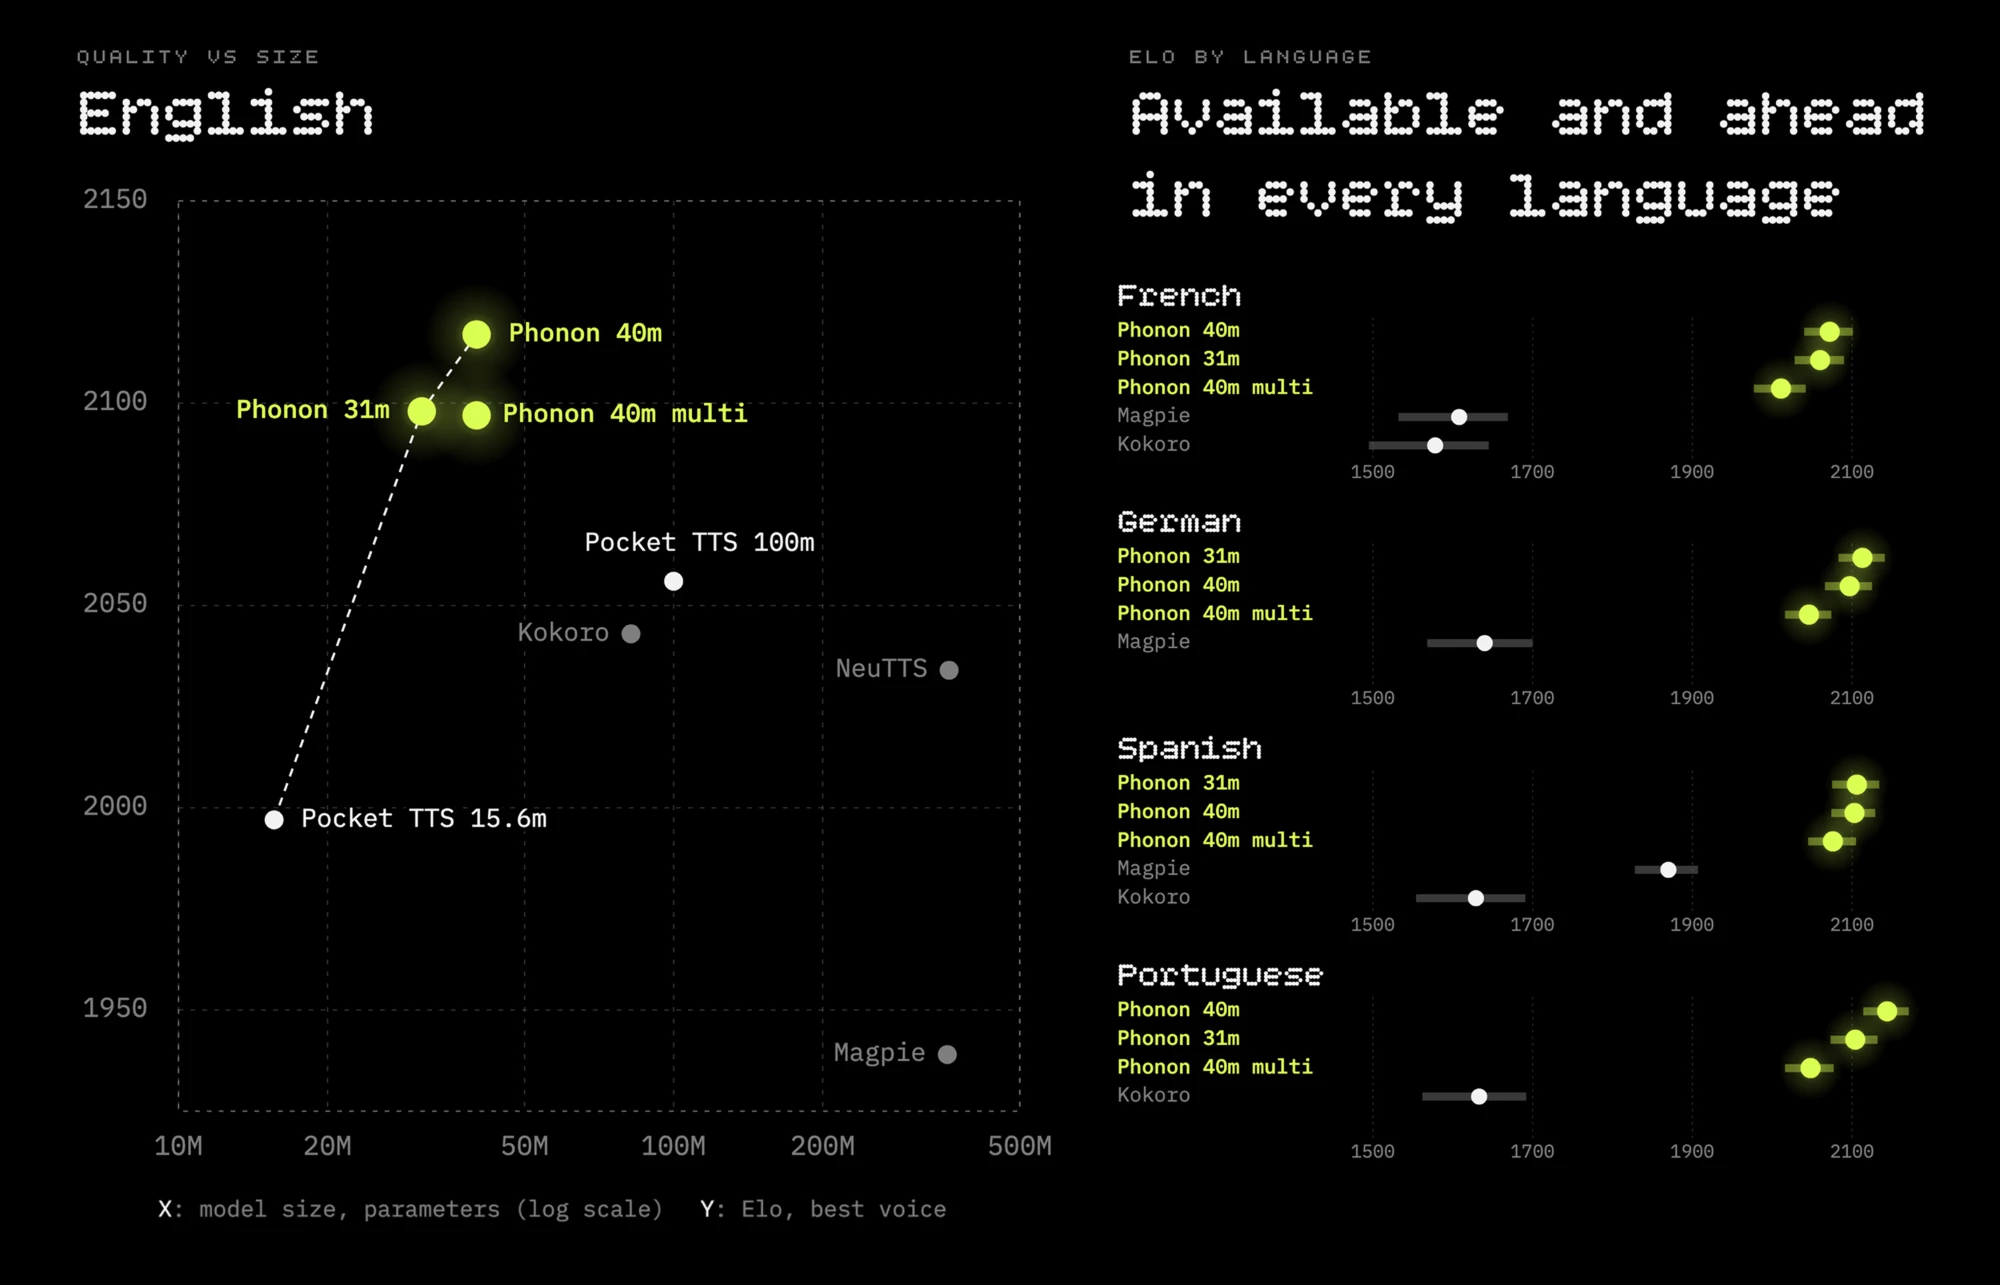
À esquerda, a qualidade (Elo) em relação ao tamanho do modelo, em inglês. À direita, a comparação em francês, alemão, espanhol e português. Os números foram divulgados pela própria Gradium.
A velocidade também impressiona. Em um MacBook Air M5, usando apenas um núcleo de CPU, o Phonon 31m começa a falar em 13,6 milissegundos e gera áudio 11,6 vezes mais rápido que o tempo real. Em um Raspberry Pi 5, ele ainda roda 3,7 vezes mais rápido que o tempo real.
Idiomas disponíveis
O Phonon chega ao Ollama em cinco idiomas, com um modelo para cada língua e uma versão multilíngue que reúne todas:
| Modelo no Ollama | Idioma | Parâmetros | Licença |
|---|---|---|---|
phonon | Inglês | 31M | Apache 2.0 |
phonon:40m-en | Inglês | 40M | CC BY-NC 4.0 |
phonon:40m-pt | Português | 40M | CC BY-NC 4.0 |
phonon:40m-es | Espanhol | 40M | CC BY-NC 4.0 |
phonon:40m-fr | Francês | 40M | CC BY-NC 4.0 |
phonon:40m-de | Alemão | 40M | CC BY-NC 4.0 |
phonon:40m-multilingual | Os cinco idiomas | 40M | CC BY-NC 4.0 |
O modelo padrão, phonon, é a versão de 31 milhões de parâmetros em inglês.
Como baixar pelo Ollama
Por enquanto, os modelos de voz funcionam apenas no macOS, em Macs com Apple Silicon, onde o Ollama usa o framework MLX da Apple para acelerar a geração. O suporte para Windows e Linux foi prometido, mas ainda não tem data. Também é preciso ter o Ollama 0.40.11 ou superior.
Atendidos esses requisitos, basta baixar o modelo e passar o texto:
ollama pull phonon:40m-pt
ollama run phonon:40m-pt "Olá! Este áudio foi gerado localmente pelo Ollama."
Para salvar o resultado em um arquivo, é só redirecionar a saída com > fala.wav. A opção --voice permite escolher outra voz do catálogo da Gradium, e o comando ollama show lista as vozes disponíveis em cada modelo. Também dá para encadear um modelo de linguagem e o Phonon em uma única linha, fazendo o primeiro escrever e o segundo falar:
ollama run gemma4 --hidethinking "Conte uma curiosidade sobre lhamas em duas frases." | ollama run phonon:40m-pt
Para desenvolvedores, o Phonon funciona pelo endpoint /v1/audio/speech, compatível com a API da OpenAI. Quem já usa o SDK da OpenAI precisa apenas trocar a URL base para http://localhost:11434/v1. O áudio sai em WAV, 24 kHz e mono, e é transmitido em streaming, então a reprodução pode começar antes de a geração terminar.
Segundo o Ollama, em um MacBook Pro com M5 Max a geração ficou 35% mais rápida do que no runtime da própria Gradium, mantendo a mesma taxa de erro da implementação de referência.
Atenção à licença
Aqui mora um detalhe importante. Apenas o modelo padrão, o Phonon 31m em inglês, usa a licença Apache 2.0, que permite uso comercial. Todos os modelos de 40 milhões de parâmetros, incluindo os de português e espanhol, estão sob a licença CC BY-NC 4.0, que restringe o uso a fins não comerciais.
Na prática, dá para testar, estudar e usar o Phonon em português em projetos pessoais à vontade. Já uma empresa que queira colocar essa voz em um produto precisa negociar diretamente com a Gradium, que oferece modelos personalizados para clientes corporativos.
Por que o Ollama é tão popular?
Um dos motivos para o Ollama ter se tornado tão popular é a simplicidade. No macOS e no Windows, a instalação é feita por um instalador comum, baixado em ollama.com/download. No Linux, basta um comando:
curl -fsSL https://ollama.com/install.sh | sh
Depois disso, rodar um modelo é questão de um ollama run, seguido do nome do modelo. O Ollama baixa os arquivos, carrega o modelo e abre uma conversa direto no terminal.
Ao mesmo tempo, ele mantém um servidor local na porta 11434, com API própria e compatibilidade com a API da OpenAI. Isso significa que boa parte das ferramentas e bibliotecas que já falam com a OpenAI passa a funcionar com modelos locais apenas trocando o endereço.
Não é só gratuito: os planos do Ollama
Rodar modelos no próprio computador é, e continua sendo, gratuito e ilimitado. Mas o Ollama também tem um serviço em nuvem, que executa modelos maiores nos servidores da empresa e é cobrado por uso, por milhão de tokens de acordo com o modelo. Cada plano inclui uma quantia mensal de créditos:
| Plano | Preço | Créditos mensais incluídos | Requisições simultâneas |
|---|---|---|---|
| Free | Gratuito | Créditos iniciais e acesso a modelos de entrada | 1 |
| Pro | US$ 20/mês ou US$ 200/ano | US$ 60 e acesso a modelos maiores | 3 |
| Max | US$ 100/mês | US$ 300 e acesso antecipado a novos modelos | 10 |
| Team | US$ 500/mês (acesso antecipado) | US$ 1.000 compartilhados, com usuários ilimitados | 10 |
| Enterprise | Sob consulta | Preço por volume, controle de acesso e orçamentos | — |
No plano gratuito, também é possível comprar créditos avulsos para liberar todos os modelos em nuvem, sem taxa de serviço.
Fora do horário de pico, ou seja, fora da faixa das 12h às 18h UTC em dias úteis e durante todo o fim de semana, o uso sai mais barato. Os créditos incluídos não acumulam de um mês para o outro.
Sobre privacidade, o Ollama afirma que prompts e respostas não são registrados nem usados para treinar modelos. A infraestrutura fica principalmente nos Estados Unidos, com possibilidade de roteamento para a Europa, e roda em parceiros da Nvidia que precisam seguir políticas de retenção zero de dados.
Ouça o Phonon em português, inglês e espanhol
O anúncio oficial do Ollama traz exemplos de áudio gerados com o Phonon, todos sem edição. Dá para ouvir a voz Davi em português, a voz Candela em espanhol e quatro vozes em inglês, com sotaques americano e britânico, além de amostras em francês e alemão. Cada exemplo vem acompanhado do comando usado para gerá-lo.
Ouça os exemplos no blog do Ollama