Ollama ahora puede generar audio a partir de texto. El primer modelo de voz de la plataforma es Phonon, de la francesa Gradium: compacto, se ejecuta localmente y tiene versiones en portugués, inglés, español, francés y alemán.
Ollama ahora es compatible con text-to-speech
Ollama anunció el 24 de octubre el soporte para modelos de text-to-speech (TTS), los que convierten texto en voz. El primer modelo disponible es Phonon, una familia de modelos de voz compactos creada por Gradium, una startup francesa especializada en IA de voz.
La novedad llama la atención por el peso de Ollama en el ecosistema. Con más de 180 mil estrellas en GitHub, el proyecto se ha convertido en uno de los mayores repositorios de modelos abiertos y en una de las principales puertas de entrada para quien quiere ejecutar IA localmente, en su propia computadora, sin depender de una API externa. Gemma, Qwen, Llama y DeepSeek están a un comando de distancia.
Hasta ahora, sin embargo, Ollama era sinónimo de modelos que leen y escriben texto. Con el soporte de voz, la plataforma pasa a cubrir también la etapa del habla: un modelo de lenguaje escribe la respuesta y Phonon la convierte en audio, todo en la misma máquina y sin que ningún dato salga de la computadora.
Quién es Gradium
Gradium es una startup de París fundada en septiembre de 2025 como un spin-off de Kyutai, un laboratorio francés de investigación en IA sin fines de lucro, financiado por el multimillonario Xavier Niel y conocido por Moshi, uno de los primeros modelos abiertos de conversación por voz en tiempo real. Al frente de la empresa está Neil Zeghidour, miembro fundador de Kyutai y exinvestigador de modelos de voz en Google DeepMind.
La propuesta de Gradium es construir modelos de voz con una latencia muy baja, para que asistentes y agentes respondan casi al instante. Su portafolio incluye modelos de texto a voz y de voz a texto en tiempo real, el traductor de voz Gradium Translate, Gradbot, un framework open source para crear agentes de voz, y ahora Phonon, pensado para ejecutarse directamente en el dispositivo.
Phonon: voz de calidad en menos de 50 millones de parámetros
Gradium liberó los pesos de Phonon el 20 de octubre. Son modelos diminutos para los estándares actuales: el más pequeño tiene 31 millones de parámetros y los demás, 40 millones, mientras que los modelos de lenguaje locales suelen tener miles de millones. En Ollama, las descargas van de 104 MB a 148 MB, y el modelo ocupa entre 120 MB y 140 MB de memoria una vez cargado.
Aun siendo pequeño, Phonon promete la calidad de modelos más grandes. En pruebas ciegas de preferencia, con más de 1.100 evaluadores y 17 mil votos, Gradium afirma que quedó por delante de las alternativas abiertas comparadas, como Kokoro, Magpie, NeuTTS y Pocket TTS, en todos los idiomas evaluados. En la tasa de error de palabras (WER), medida en 500 frases difíciles, Phonon 31m obtuvo un 1,70%, frente al 3,50% de Kokoro.
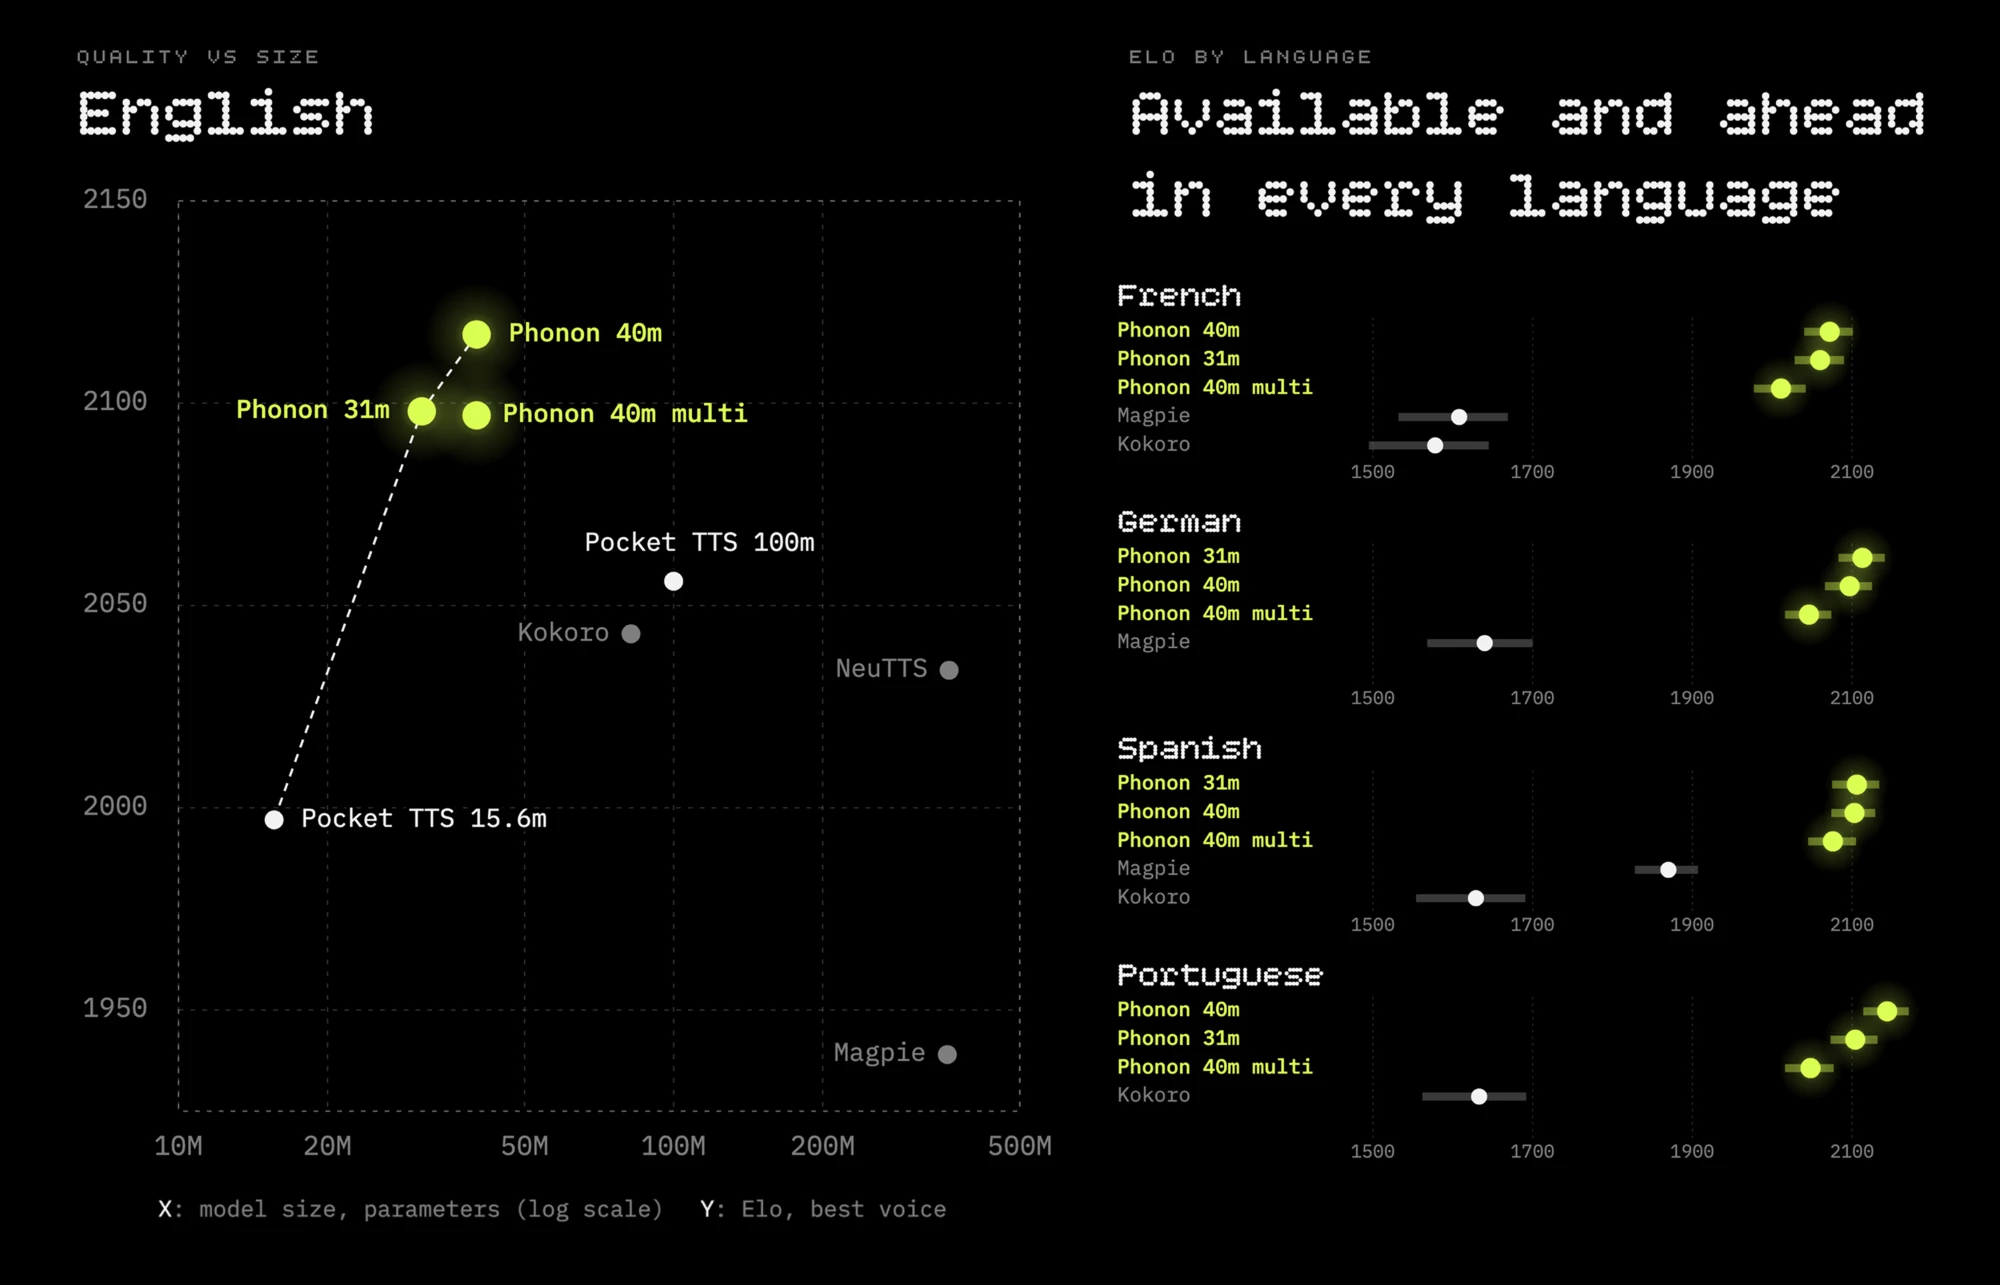
A la izquierda, la calidad (Elo) en relación con el tamaño del modelo, en inglés. A la derecha, la comparación en francés, alemán, español y portugués. Las cifras fueron publicadas por la propia Gradium.
La velocidad también impresiona. En una MacBook Air M5, usando un solo núcleo de CPU, Phonon 31m empieza a hablar en 13,6 milisegundos y genera audio 11,6 veces más rápido que el tiempo real. En una Raspberry Pi 5, sigue funcionando 3,7 veces más rápido que el tiempo real.
Idiomas disponibles
Phonon llega a Ollama en cinco idiomas, con un modelo para cada lengua y una versión multilingüe que los reúne a todos:
| Modelo en Ollama | Idioma | Parámetros | Licencia |
|---|---|---|---|
phonon | Inglés | 31M | Apache 2.0 |
phonon:40m-en | Inglés | 40M | CC BY-NC 4.0 |
phonon:40m-pt | Portugués | 40M | CC BY-NC 4.0 |
phonon:40m-es | Español | 40M | CC BY-NC 4.0 |
phonon:40m-fr | Francés | 40M | CC BY-NC 4.0 |
phonon:40m-de | Alemán | 40M | CC BY-NC 4.0 |
phonon:40m-multilingual | Los cinco idiomas | 40M | CC BY-NC 4.0 |
El modelo predeterminado, phonon, es la versión de 31 millones de parámetros en inglés.
Cómo descargarlo con Ollama
Por ahora, los modelos de voz solo funcionan en macOS, en Macs con Apple Silicon, donde Ollama usa el framework MLX de Apple para acelerar la generación. El soporte para Windows y Linux está prometido, pero todavía no tiene fecha. También es necesario tener Ollama 0.40.11 o superior.
Cumplidos estos requisitos, basta con descargar el modelo y pasarle el texto:
ollama pull phonon:40m-es
ollama run phonon:40m-es "¡Hola! Este audio fue generado localmente por Ollama."
Para guardar el resultado en un archivo, solo hay que redirigir la salida con > voz.wav. La opción --voice permite elegir otra voz del catálogo de Gradium, y el comando ollama show muestra las voces disponibles en cada modelo. También se puede encadenar un modelo de lenguaje y Phonon en una sola línea, para que el primero escriba y el segundo hable:
ollama run gemma4 --hidethinking "Cuéntame un dato curioso sobre las llamas en dos frases." | ollama run phonon:40m-es
Para desarrolladores, Phonon funciona a través del endpoint /v1/audio/speech, compatible con la API de OpenAI. Quien ya usa el SDK de OpenAI solo necesita cambiar la URL base a http://localhost:11434/v1. El audio sale en WAV, 24 kHz y mono, y se transmite en streaming, así que la reproducción puede comenzar antes de que termine la generación.
Según Ollama, en una MacBook Pro con M5 Max la generación fue un 35% más rápida que en el runtime de la propia Gradium, manteniendo la misma tasa de error que la implementación de referencia.
Atención a la licencia
Aquí hay un detalle importante. Solo el modelo predeterminado, Phonon 31m en inglés, usa la licencia Apache 2.0, que permite el uso comercial. Todos los modelos de 40 millones de parámetros, incluidos los de portugués y español, están bajo la licencia CC BY-NC 4.0, que restringe el uso a fines no comerciales.
En la práctica, se puede probar, estudiar y usar Phonon en español en proyectos personales con total libertad. Pero una empresa que quiera incorporar esa voz en un producto debe negociar directamente con Gradium, que ofrece modelos personalizados para clientes corporativos.
¿Por qué Ollama es tan popular?
Uno de los motivos por los que Ollama se volvió tan popular es su simplicidad. En macOS y Windows, la instalación se hace con un instalador común, descargado desde ollama.com/download. En Linux, basta un comando:
curl -fsSL https://ollama.com/install.sh | sh
Después de eso, ejecutar un modelo es cuestión de un ollama run seguido del nombre del modelo. Ollama descarga los archivos, carga el modelo y abre una conversación directamente en la terminal.
Al mismo tiempo, mantiene un servidor local en el puerto 11434, con API propia y compatibilidad con la API de OpenAI. Esto significa que buena parte de las herramientas y bibliotecas que ya se comunican con OpenAI pasan a funcionar con modelos locales con solo cambiar la dirección.
No todo es gratis: los planes de Ollama
Ejecutar modelos en la propia computadora es, y sigue siendo, gratuito e ilimitado. Pero Ollama también tiene un servicio en la nube, que ejecuta modelos más grandes en los servidores de la empresa y se cobra por uso, por millón de tokens según el modelo. Cada plan incluye una cantidad mensual de créditos:
| Plan | Precio | Créditos mensuales incluidos | Solicitudes simultáneas |
|---|---|---|---|
| Free | Gratis | Créditos iniciales y acceso a modelos de entrada | 1 |
| Pro | US$ 20/mes o US$ 200/año | US$ 60 y acceso a modelos más grandes | 3 |
| Max | US$ 100/mes | US$ 300 y acceso anticipado a nuevos modelos | 10 |
| Team | US$ 500/mes (acceso anticipado) | US$ 1.000 compartidos, con usuarios ilimitados | 10 |
| Enterprise | A consultar | Precio por volumen, control de acceso y presupuestos | — |
En el plan gratuito, también es posible comprar créditos adicionales para desbloquear todos los modelos en la nube, sin tarifa de servicio.
Fuera del horario pico, es decir, fuera de la franja de 12:00 a 18:00 UTC en días hábiles y durante todo el fin de semana, el uso sale más barato. Los créditos incluidos no se acumulan de un mes a otro.
En cuanto a privacidad, Ollama afirma que los prompts y las respuestas no se registran ni se usan para entrenar modelos. La infraestructura está principalmente en Estados Unidos, con posibilidad de enrutamiento a Europa, y funciona con socios de Nvidia que deben seguir políticas de retención cero de datos.
Escucha Phonon en portugués, inglés y español
El anuncio oficial de Ollama incluye ejemplos de audio generados con Phonon, todos sin edición. Se puede escuchar la voz Davi en portugués, la voz Candela en español y cuatro voces en inglés, con acentos estadounidense y británico, además de muestras en francés y alemán. Cada ejemplo viene acompañado del comando usado para generarlo.
Escucha los ejemplos en el blog de Ollama